
周六早上八点,手机一震,朋友发来消息:「你网站怎么打不开了?」打开一看,浏览器转了半天,最后蹦出「无法访问此网站」。昨晚明明还好好的,什么都没动过,网站说挂就挂了。更糟的是,第一反应往往是手忙脚乱:重启服务器、重启 Nginx、重启数据库,轮番重启一圈,网站还是打不开,时间却一分一秒过去了。
其实网站打不开,原因就那么几类:域名解析断了、服务器没响应、Web 服务挂了、后端程序崩了、数据库连不上。报错信息本身已经把范围缩小了一大半,关键是按顺序逐段排查,而不是原地重启碰运气。这篇就按「浏览器 → 域名 → 服务器 → Nginx → 程序 → 数据库」这条链路,一步步走一遍,每步给确切命令和预期结果,照着敲,十分钟就能定位到哪一段出了问题。
先看报错:三种报错对应三种方向
动手之前先读报错,这一步能省掉一半的排查时间。浏览器报「无法访问此网站」「连接超时」,大概率是域名解析或服务器网络的问题,请求根本没到服务器;报「502 Bad Gateway」,说明 Nginx 活着,但它后面的程序没接上;报「503 Service Unavailable」或「500」,说明程序接上了,但自己内部出了错;报「证书错误」「连接不是私密连接」,则是 HTTPS 证书的问题,和服务器本身没关系。
还有一个很容易忽略的判断:只在你自己的电脑上打不开,还是换手机、用流量也打不开?如果只有你这边打不开,先清浏览器缓存、换个网络试试,可能是本地 DNS 缓存或运营商的问题;如果到处都打不开,再去服务器上排查。先分清是「全网故障」还是「只有你」,能避免很多无用功。
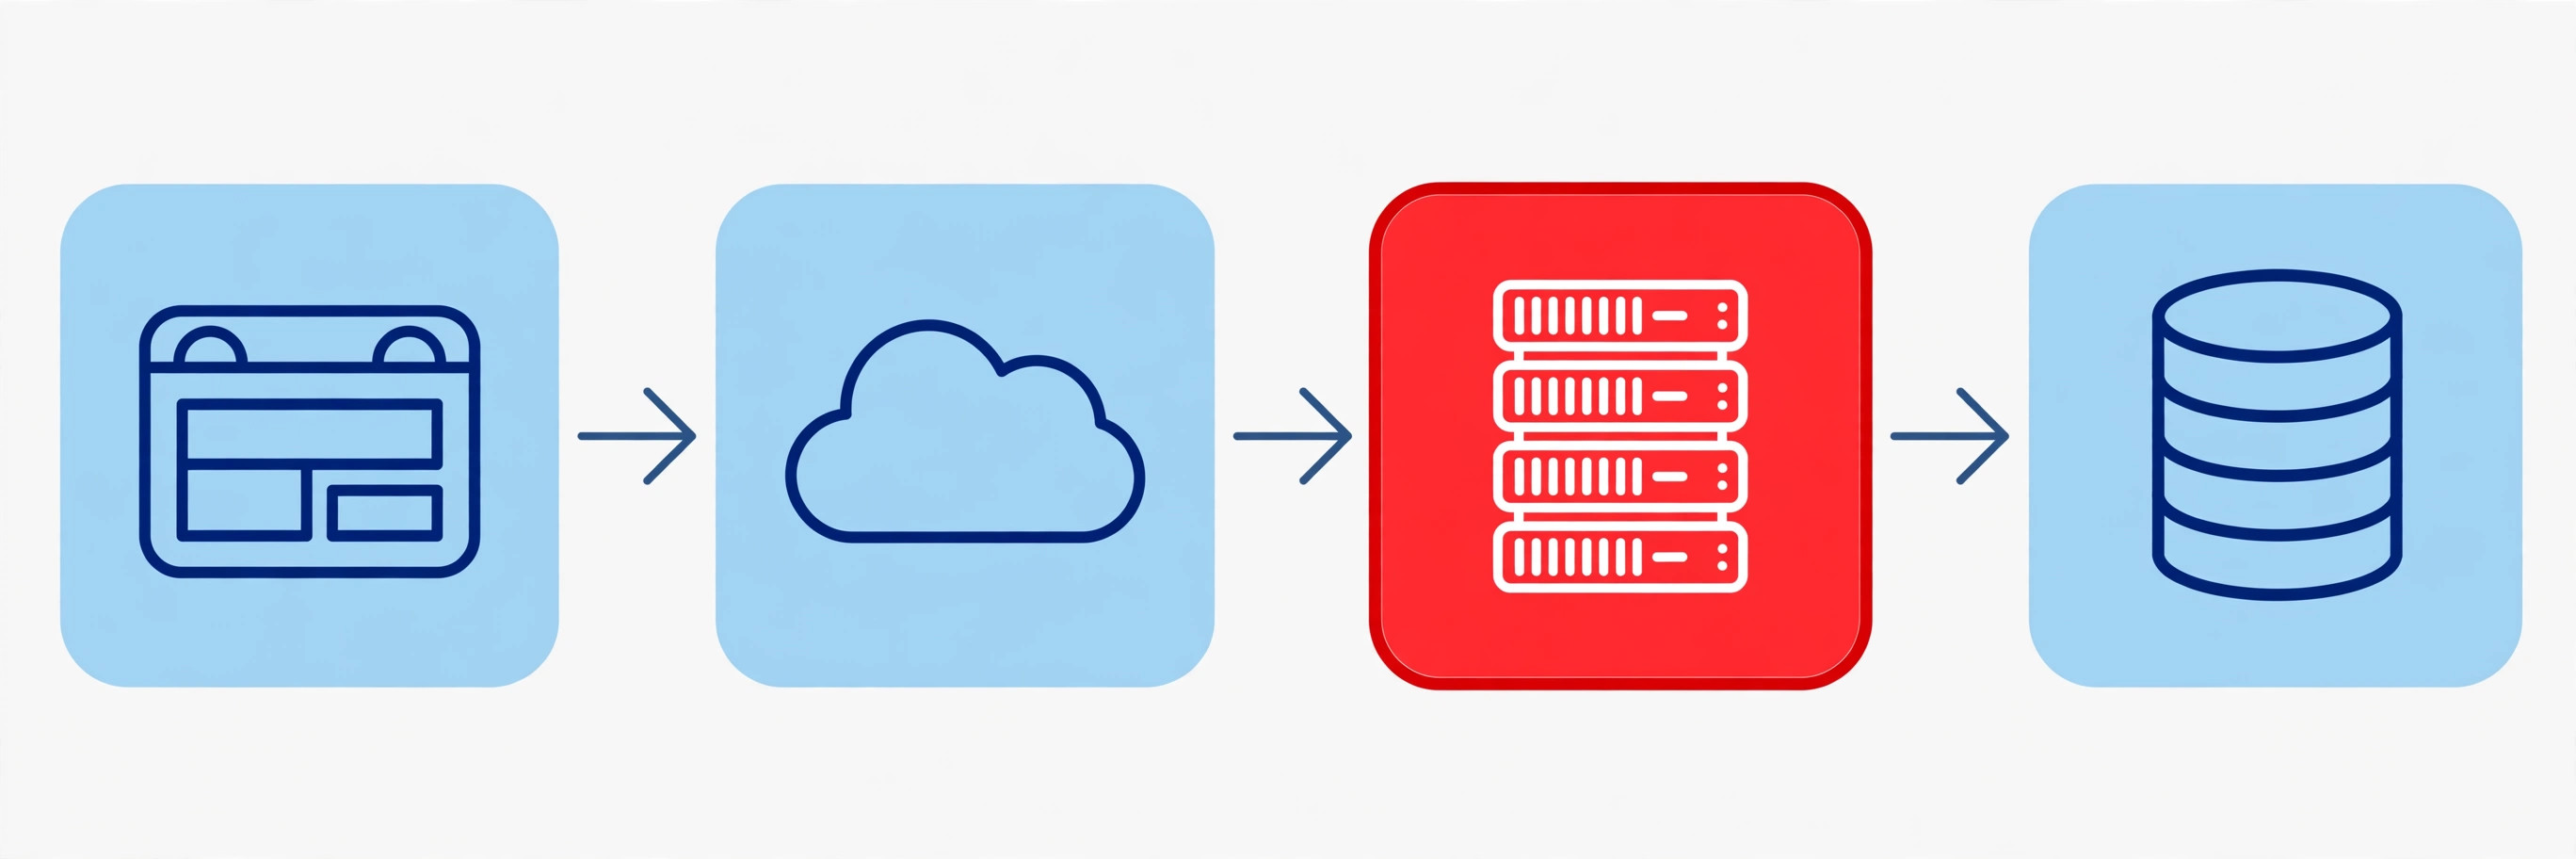
图:一次访问要经过浏览器、域名、服务器、程序、数据库五段,故障就藏在其中某一段
第一步:域名解析对不对
在自己电脑上查一下域名解析到哪里了:
预期结果:ping 能看到一个 IP 地址,而且就是你的服务器 IP。如果解析出来的 IP 不对,或者干脆解析失败,先去域名解析后台检查 A 记录——是不是过期续费后解析被改了、是不是手滑删了记录。解析刚改过的话要等生效,全球生效一般需要几分钟到几十分钟不等,这段时间耐心等,别反复改。
如果解析没问题但 ping 不通,可能是服务器本身关机了,或者云厂商安全组把端口挡住了。先到云厂商控制台看一眼实例状态是不是运行中,再确认安全组放行了 80 和 443 端口。
第二步:服务器活着吗,Web 服务在跑吗
能 SSH 登录服务器,说明机器本身是活的,问题在服务层。先看 Nginx 和程序进程在不在:
如果 Nginx 显示 inactive 或者进程列表里根本没有它,先看它为什么起不来——直接重启之前,先看日志,日志会告诉你真实原因:
最常见的两种死因:一是配置文件写错了,改配置后没做语法检查就重启,Nginx 直接拒绝启动;二是 80 或 443 端口被别的程序占了。端口被占这样查:
nginx -t 是改完配置后必做的语法检查,输出 "syntax is ok" 和 "test is successful" 才算通过。如果是端口冲突,先看 ss 输出里占着端口的是谁,再决定停掉它还是改 Nginx 的监听端口。确认没问题再重启:systemctl restart nginx。
图:先看日志再动手,错误日志里往往直接写着故障原因
第三步:502 和 500 分别往哪查
如果浏览器报 502,Nginx 是活的,问题在它后面的程序。先看 Nginx 的错误日志,里面一般会写 "connect() failed" 或 "upstream timed out",并标明它连不上的是哪个地址和端口。再看后端程序是不是真的在监听那个端口:
curl 本地能通,说明后端活着,可能是 Nginx 配置里的转发地址写错了;curl 本地也不通,说明后端程序挂了,重启它再看:systemctl restart php8.2-fpm,重启后重复 curl 验证一次。
如果报 500,程序接上了但自己报错了。这时去看程序自己的日志:PHP 看 /var/log/php-fpm/ 下的错误日志,Python 程序看应用自己的日志文件,重点找最近一次报错的时间点和堆栈。常见原因就几个:数据库连不上、磁盘满了导致写不进文件、某个依赖升级后不兼容。磁盘满了这样快速确认:
df -h 里某块盘用了 100%,程序基本就写不进任何东西了,数据库也可能直接拒绝写入。先清掉可以删的旧日志和缓存文件恢复服务,再回头找是谁把磁盘吃满的。
第四步:数据库连不上怎么办
很多「网站打不开」的终点其实是数据库。先确认数据库进程在不在、能不能连上:
进程不在,先看 MySQL 的错误日志,一般在 /var/log/mysql/error.log,磁盘满、内存不足、配置文件错误都会让它起不来。进程在但连不上,先看程序的数据库配置:主机、端口、用户名、密码有没有被改过,数据库用户有没有被误删。改配置、改密码之后,一定要重启程序让新配置生效,只改文件不重启是最常见的「明明改对了还是不行」。
⚠️ 提醒:数据库出问题时千万别上来就删库、删表、重装。先备份再动手,哪怕是 mysqldump 快速导一份也行。很多站长都是在「修」数据库的时候把数据弄丢的,故障本身反而没丢数据。
完整案例:一个博客站从全站 502 到 9 分钟恢复
拿一个真实的个人博客站举例:2 核 2G 的云服务器,Nginx + PHP + MySQL,平时访问量每天三四百。某天上午 9 点 12 分,站长收到访客反馈:首页打不开,浏览器显示 502 Bad Gateway。
现象确认:手机流量打开也是 502,说明是全网故障,不是本地网络问题。SSH 登录服务器正常,机器活着。
排查:先看 Nginx 状态,active 正常;再看 Nginx 错误日志,最新一条是 "connect() failed (111: Connection refused) while connecting to upstream",意思是它连不上后端的 PHP-FPM。再执行 systemctl status php8.2-fpm,显示 inactive,进程已经停了;查 PHP-FPM 的错误日志,最后一条是 "unable to allocate memory",内存分配失败。再看内存:free -h 显示可用内存只剩 38MB,top 里一个定时备份脚本正在跑,把内存吃满了,系统把 PHP-FPM 杀掉了。
处置:先停掉那个正在跑的备份脚本释放内存,再 systemctl restart php8.2-fpm,curl 本地验证返回 200,浏览器刷新,首页恢复,时间是 9 点 21 分,全程 9 分钟。随后把备份脚本改到凌晨 3 点执行,并加了内存上限,避免白天再抢内存。
复查:恢复后连续观察一小时,502 没有再出现;第二天同一时段再查,PHP-FPM 稳定运行,备份脚本在凌晨正常完成。故障根因不是 Nginx 也不是程序 bug,而是一个定时任务在高峰时段抢光了内存——只重启 Nginx 永远修不好它。
三个最容易把自己坑了的点
1. 上来就重启全套服务。重启会清空很多现场:进程没了、内存占用没了、错误日志被轮转了,本来能直接定位的问题变成无头案。先看日志、先查状态,重启是最后一步,不是第一步。
2. 改配置不做语法检查就重启。Nginx、PHP-FPM、MySQL 都有配置检查命令(nginx -t、php-fpm -t、mysqld --validate-config),改完先检查再重启,写错一个字符都可能让服务起不来。
3. 修数据库之前不备份。数据库的问题最怕「越修越坏」,动手前先 mysqldump 导出一份,十分钟的备份能省下几天的后悔。
小结清单
① 看报错定方向:超时是网络和解析,502 是后端没接上,500 是程序内部错;② ping 和 nslookup 验域名解析;③ systemctl status + 日志看 Nginx 和后端进程;④ curl 本地验证后端,df -h 排查磁盘满;⑤ 数据库先看日志、动手前先备份;⑥ 恢复后观察一小时,确认故障不再复发才算完。这张清单贴在手边,下次网站打不开,就按顺序一项项打勾,十分钟定位不是运气,是方法。